这次 AI 升级,卖点是「它学会了说不知道」
被大模型幻觉坑过的你,一定知道本文标题的含金量。
5月28日,Anthropic发布了新一代旗舰模型Claude Opus 4.8。
如果你已经对“某某大模型又双叒更新了”感到疲惫,我理解。这类发布往往长一个样:一堆跑分图、几个“全面超越”的箭头、一句“史上最强”。但这次有点不一样——不是因为它更强了多少,而是因为厂商自己都没怎么吹。
Anthropic给这次升级的官方定语是:“相对前代,温和但实在的改进。”
在一个习惯了“颠覆”“碾压”“遥遥领先”的行业里,这句克制得近乎反常的话,反而值得我们认真聊聊。
先说大家最关心的:它到底强在哪
简单说,Opus 4.8把力气主要花在了“干活”上——也就是让AI像个能独立完成任务的助手,而不只是聊天对象。
最明显的进步在写代码。在一项模拟真实工程难题的测试(SWE-Bench Pro)里,它的得分从前代的64.3%提到了69.2%;在更贴近实战的终端操作测试里,提升幅度更大。换成人话:它现在更像一个“不用你时时盯着、能自己把一摊活干完”的工程师,而不是一个需要你手把手带的实习生。
此外,它还附带了几个实用变化:新增了“快速模式”,同样的能力跑得更快、还更便宜;在网页版里多了一个“用力程度”开关,让你自己决定它是该慢慢深思,还是赶紧给答案省点额度。价格则和前代持平。
这些都是好事,但说实话,放在整个行业里,它们属于“扎实的常规迭代”,算不上石破天惊。
真正有意思的,是它学会了“诚实”
这一代被反复强调的特质,是一个听起来不太像技术指标的词:诚实。
具体来说,据Anthropic的测试,新模型主动标记“我对这部分不太确定”的倾向明显增强,而硬着头皮给出没有依据的断言的情况大幅减少。一个很具体的数字是:它放任自己写出的代码里藏着缺陷、却闷不吭声地蒙混过去的概率,大约只有前代的四分之一。
为什么这件事对普通用户更重要?
因为大模型最危险的毛病,从来不是“不够聪明”,而是“一本正经地胡说八道”。它可以用流畅、自信、措辞专业的语气,给你一个完全错误的答案——你还很难一眼看穿。一个肯说“这里我没把握,你最好再核实一下”的AI,有时候比一个永远信誓旦旦的AI更值得托付。
这不是煽情。它背后是实打实的训练方向:让模型在没有把握时,选择坦白,而不是表演。
那它是不是“吊打”了OpenAI和谷歌?
这是大家最想问、也最容易被带节奏的问题。先给个诚实的提醒:接下来这些跨厂商的对比数字,几乎全部出自Anthropic自己发布的评测。
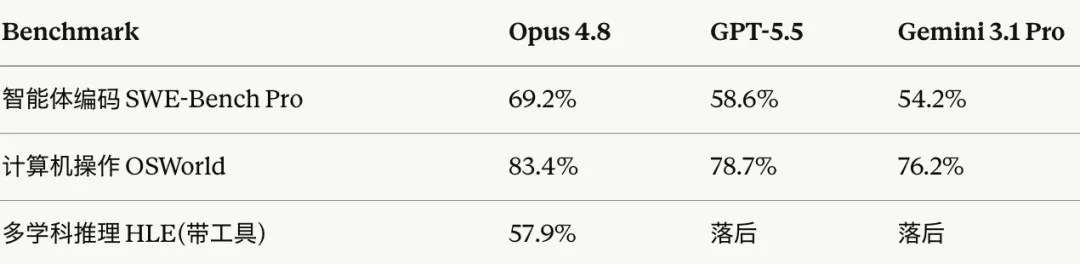
按这套数据,Opus 4.8在智能体编码、电脑操作、多学科推理等几项上,领先OpenAI的GPT-5.5和谷歌的Gemini 3.1 Pro。但更值得注意的,是宣传图里常被淡化的另一面:在终端/命令行这类工作流上,GPT-5.5反而更强;在网页浏览、研究生级别的科学难题上,两者基本打平。
所以更准确的说法不是“全面碾压”,而是“互有胜负、各有所长”。任何一家在发布日给你看的对比图,都是它精心挑过、自己赢的那几项。真想判断高下,看第三方盲测排行(比如LMArena)会比看任何一家的官方海报靠谱得多。
还有个少有人提的背景:Anthropic内部其实还藏着一个更强的模型(代号Mythos),目前只对极少数机构开放。换句话说,Opus 4.8也不是它手里最强的那一个,只是目前向你我这样的普通用户公开的、最强的那一个。
写在最后
剥掉营销语言,这次发布的真实面貌大概是:一次扎实但不算颠覆的升级,编码和“干活”能力稳步前进,价格没涨,速度更快。
但如果要我挑一个最值得普通人记住的点,那不是任何一个跑分,而是它被着重训练出来的那个新习惯——在不确定的时候,先承认不确定。
在一个比谁更自信、更全能、更“遥遥领先”的赛道上,有人开始认真地教AI说“这个我不太确定,你再查查”。这件事本身,可能比多几个百分点的分数更有分量。